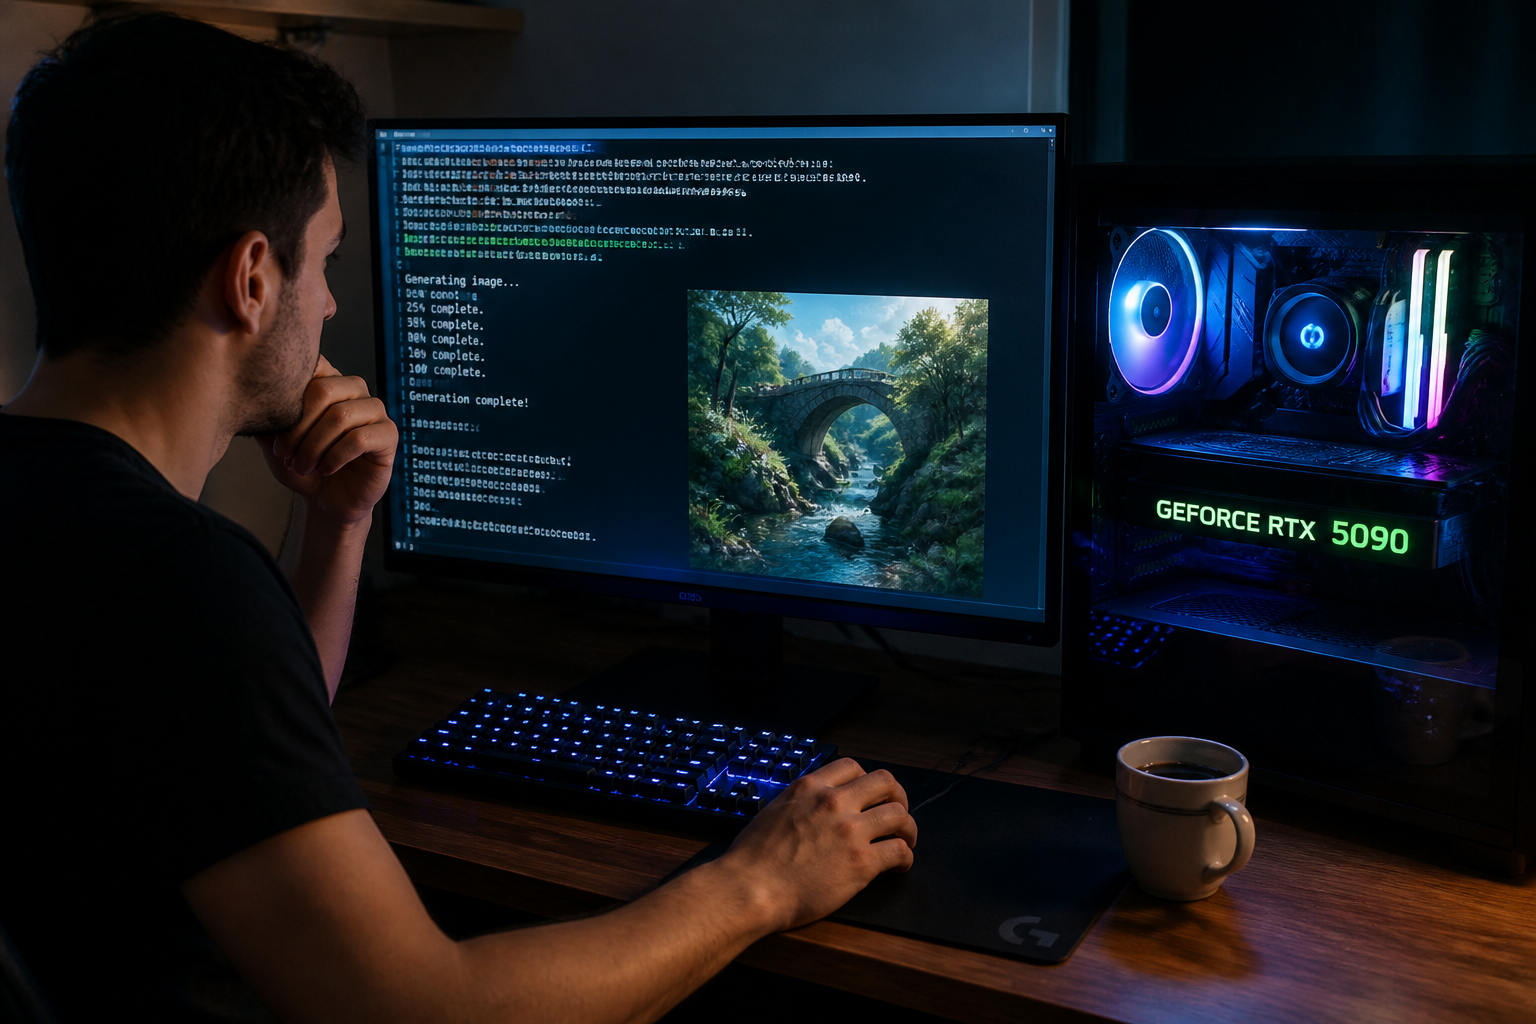
Faire tourner un modèle de langage (LLM) ou générer des images directement sur son PC, sans passer par un serveur distant, devient accessible avec une carte graphique récente. La promesse est séduisante : confidentialité totale, pas d'abonnement, latence quasi nulle. Mais concrètement, que peut-on espérer avec une RTX 5060, une 5070 Ti ou une 5090 ? Le facteur décisif n'est pas la puissance brute en jeux, mais la quantité de mémoire vidéo (VRAM). Un modèle de 70 milliards de paramètres ne tient pas dans 8 Go, et un modèle de 7B peut être décevant si la VRAM est trop juste. Voici ce que chaque carte permet vraiment, et où se situent les limites.
VRAM : le plafond de verre de l'IA locale
La VRAM est le premier goulot d'étranglement. Un LLM doit être chargé intégralement dans la mémoire du GPU pour fonctionner à pleine vitesse. Si la VRAM est insuffisante, le système bascule sur la RAM système, ce qui ralentit considérablement la génération de texte. Un modèle de 7B paramètres en quantification Q4 (une compression légère) occupe environ 4 à 6 Go. Un modèle de 13B en Q4 nécessite 8 à 10 Go. Un 70B en Q4, lui, demande environ 35 à 40 Go. Sans cette mémoire, l'inférence devient très lente, parfois inutilisable.
Voici un tableau récapitulatif des GPU NVIDIA récents et de ce qu'ils autorisent en local, hors offload (délestage vers la RAM) :
| Modèle GPU | VRAM | Taille de modèle max en local (Q4) | Exemples de modèles exploitables |
|---|---|---|---|
| RTX 5060 | 8 Go | 7B | Llama 3.2 3B, Gemma 2 9B (quantifié) |
| RTX 5060 Ti 16 Go | 16 Go | 13B – 20B | Qwen 3 14B, Phi-4 14B, Mistral Small 3.1 |
| RTX 5070 / 5070 Ti | 12–16 Go | 20B – 30B (avec offload partiel) | Qwen 3 32B (Q4 partiel), modèles multimodaux |
| RTX 5080 | 16 Go | 20B – 30B+ | Mixtral MoE, Llama 3.3 70B (offload) |
| RTX 5090 | 32 Go | 70B natif | Llama 3.3 70B, Qwen 3 72B, agents complexes |
| RTX 3090 (occasion) | 24 Go | 30B – 40B | Mistral Large 2, Llama 3.3 70B (offload) |
Le constat est simple : avec 8 Go, vous êtes limité aux petits modèles (7B ou moins). Avec 16 Go, vous accédez aux modèles intermédiaires (13B-20B). Avec 24 Go (RTX 3090 d'occasion), vous pouvez viser des modèles de 30B à 40B. Et avec 32 Go (RTX 5090), les modèles 70B deviennent jouables, mais pas en FP16 (format non compressé).
Quantification : la technique pour faire tenir un gros modèle dans peu de VRAM
La quantification réduit la précision numérique des poids du modèle (passage de 16 bits à 4 bits par exemple). Cela permet de diviser par quatre la mémoire nécessaire, avec une perte de qualité souvent imperceptible pour du texte. Les formats GGUF (pour CPU/GPU hybride) et EXL2 (pour GPU pur) sont les plus courants. Un modèle 70B en Q4_K_M tient dans 40 Go de VRAM, contre 140 Go en FP16. Sans quantification, même une RTX 5090 serait trop juste pour un 70B.
Attention : la quantification n'est pas magique. Un modèle 70B très quantifié (Q2 ou Q3) peut perdre en cohérence sur des tâches complexes. Le bon compromis pour du texte courant est Q4_K_M ou Q5_K_M. Pour de la génération d'images (Stable Diffusion, Flux), la quantification est moins répandue et la VRAM reste le facteur limitant.
Multi-GPU : une solution économique mais technique
Assembler deux cartes graphiques permet de cumuler leur VRAM. Par exemple, deux RTX 5060 Ti 16 Go offrent 32 Go de VRAM totale. C'est une alternative moins coûteuse qu'une RTX 5090 pour atteindre la capacité nécessaire à un modèle 70B. Mais cette approche a des contraintes :
- Consommation électrique élevée (deux cartes = double facture et chaleur).
- Nécessité d'une carte mère avec deux slots PCIe espacés et une alimentation puissante (1000W minimum).
- Le bus PCIe peut brider les échanges entre les deux GPU, ce qui ralentit l'inférence.
- La configuration logicielle (CUDA, configuration des modèles) est plus complexe qu'avec un seul GPU.
Pour un utilisateur expérimenté, le multi-GPU reste une option valable. Pour un débutant, un seul GPU avec 24 Go (RTX 3090 d'occasion) est plus simple et plus stable.
RAM et CPU : ne pas négliger l'environnement
Le GPU fait le gros du travail, mais la RAM système et le CPU jouent un rôle de soutien critique. La RAM stocke le contexte de la conversation, le cache intermédiaire et les données d'entrée/sortie. Pour un modèle 7B, 32 Go de RAM suffisent. Pour un 70B, il faut 64 Go minimum, voire 128 Go si vous utilisez l'offload (délestage du modèle sur la RAM).
Le CPU prépare les données avant de les envoyer au GPU. Un processeur 6 cœurs (Ryzen 5 ou Core i5) est un minimum. En dessous, le CPU peut brider le GPU. Le stockage doit être un SSD NVMe : les modèles pèsent plusieurs dizaines de gigaoctets, un disque dur ou un SATA SSD ralentirait le chargement.
Voici les configurations minimales recommandées :
- Pour un modèle 7B (entrée de gamme) : RTX 5060 8 Go, 32 Go RAM, SSD NVMe 1 To, CPU 6 cœurs.
- Pour un modèle 20B (usage intermédiaire) : RTX 5060 Ti 16 Go ou RTX 5070 12 Go, 32 Go RAM (64 Go conseillé), SSD NVMe 2 To.
- Pour un modèle 70B (usage avancé) : RTX 5090 32 Go ou deux RTX 5060 Ti 16 Go, 64 Go RAM (128 Go idéal), SSD NVMe 2 To.
Ce que l'IA locale ne remplace pas (encore)
Un modèle local, même performant, n'atteint pas le niveau des très gros modèles cloud comme GPT-4 ou Claude 3.5 Opus pour les tâches complexes de raisonnement, de synthèse ou de création. Les modèles 7B ou 13B sont excellents pour du résumé, de la rédaction simple, du code basique, mais ils peinent sur des instructions nuancées ou des contextes longs. Un modèle 70B local (comme Llama 3.3 70B) rivalise avec GPT-3.5, mais pas avec GPT-4.
Autre limite : la génération d'images (Stable Diffusion, Flux) consomme beaucoup de VRAM. Un modèle comme Flux.1 nécessite 16 à 24 Go de VRAM pour des images en 1024x1024. Avec 8 Go, vous serez limité à des résolutions basses et des temps de génération longs.
Faut-il attendre les nouvelles générations ou acheter maintenant ?
Les RTX 5000 sont disponibles. Les RTX 6000 (pro) offrent 48 Go mais à un prix très élevé. Le marché de l'occasion sur les RTX 3090 (24 Go) reste pertinent pour ceux qui veulent un bon rapport VRAM/prix. Attention : une RTX 3090 d'occasion consomme beaucoup (350W) et chauffe. Prévoyez un bon refroidissement.
Si votre besoin est clair (modèles 7B à 20B), une RTX 5060 Ti 16 Go ou une RTX 5070 12 Go sont des choix équilibrés. Si vous voulez viser les modèles 70B sans vous ruiner, l'achat de deux RTX 5060 Ti 16 Go d'occasion peut être une stratégie, à condition de maîtriser la configuration multi-GPU. Si la simplicité prime, une RTX 5090 32 Go est le meilleur choix, mais le budget est conséquent.
Ne partez pas sur une carte avec 8 Go de VRAM si vous voulez faire autre chose que des tests. Vous serez rapidement bloqué. Et n'oubliez pas la RAM : 32 Go est un minimum, 64 Go est un confort pour les modèles intermédiaires, 128 Go devient nécessaire pour les très gros modèles avec offload. L'IA locale est un investissement sur la mémoire avant tout.