Face à la multiplication des besoins en données fiables et actualisées, le web scraping occupe une place centrale dans la boîte à outils des professionnels du numérique. Que ce soit pour suivre les prix des concurrents, réaliser une veille sectorielle ou extraire des informations d’offres d’emploi, l’automatisation par un site scraper Python séduit de plus en plus d’acteurs. Mais cette automatisation n’est pas sans conséquences : entre exigences techniques, impératifs juridiques et respect de l’éthique, chaque étape doit être pensée pour rester dans un cadre légal et responsable. L’année 2026 marque notamment un durcissement des attentes autour de la conformité RGPD et de la prise en compte des limitations imposées par le fichier robots.txt. Cette enquête expose les mécanismes à connaître, outils de référence et étapes concrètes pour mettre en place un scraping éthique sans risquer de franchir la ligne rouge, que ce soit par inadvertance ou excès de zèle.
En bref :
- Le web scraping automatisé avec Python connaît un essor inédit, porté par les besoins en données accessibles.
- Respecter le fichier robots.txt et les CGU d’un site est indispensable pour une approche éthique et légale.
- Des outils majeurs (Requests, BeautifulSoup, Selenium, Scrapy) permettent d’adapter le scraping aux différents types de contenus.
- En France et au sein de l’UE, le web scraping est soumis au RGPD, à la propriété intellectuelle et au droit sui generis sur les bases de données.
- Des pratiques responsables – comme l’espacement des requêtes et la réalisation d’une AIPD en cas de collecte de données personnelles – permettent de limiter les risques juridiques.
- La non-conformité peut exposer toute entité à des sanctions financières et pénales conséquentes.
Comprendre ce qu'est le web scraping et comment un site scraper fonctionne avec Python
À l’ère de la donnée, l’extraction automatisée d'informations depuis les sites web est devenue un atout stratégique pour de nombreux acteurs économiques. Le web scraping consiste à récupérer, organiser puis analyser des volumes de données initialement destinées à être lues via un navigateur. L’intérêt ? Automatiser la veille concurrentielle, l’analyse de marché ou encore la construction de référentiels à partir de données publiques, tout en évitant le travail manuel fastidieux du copier-coller ligne à ligne. Mais comment un site scraper Python réalise-t-il concrètement cette opération ?
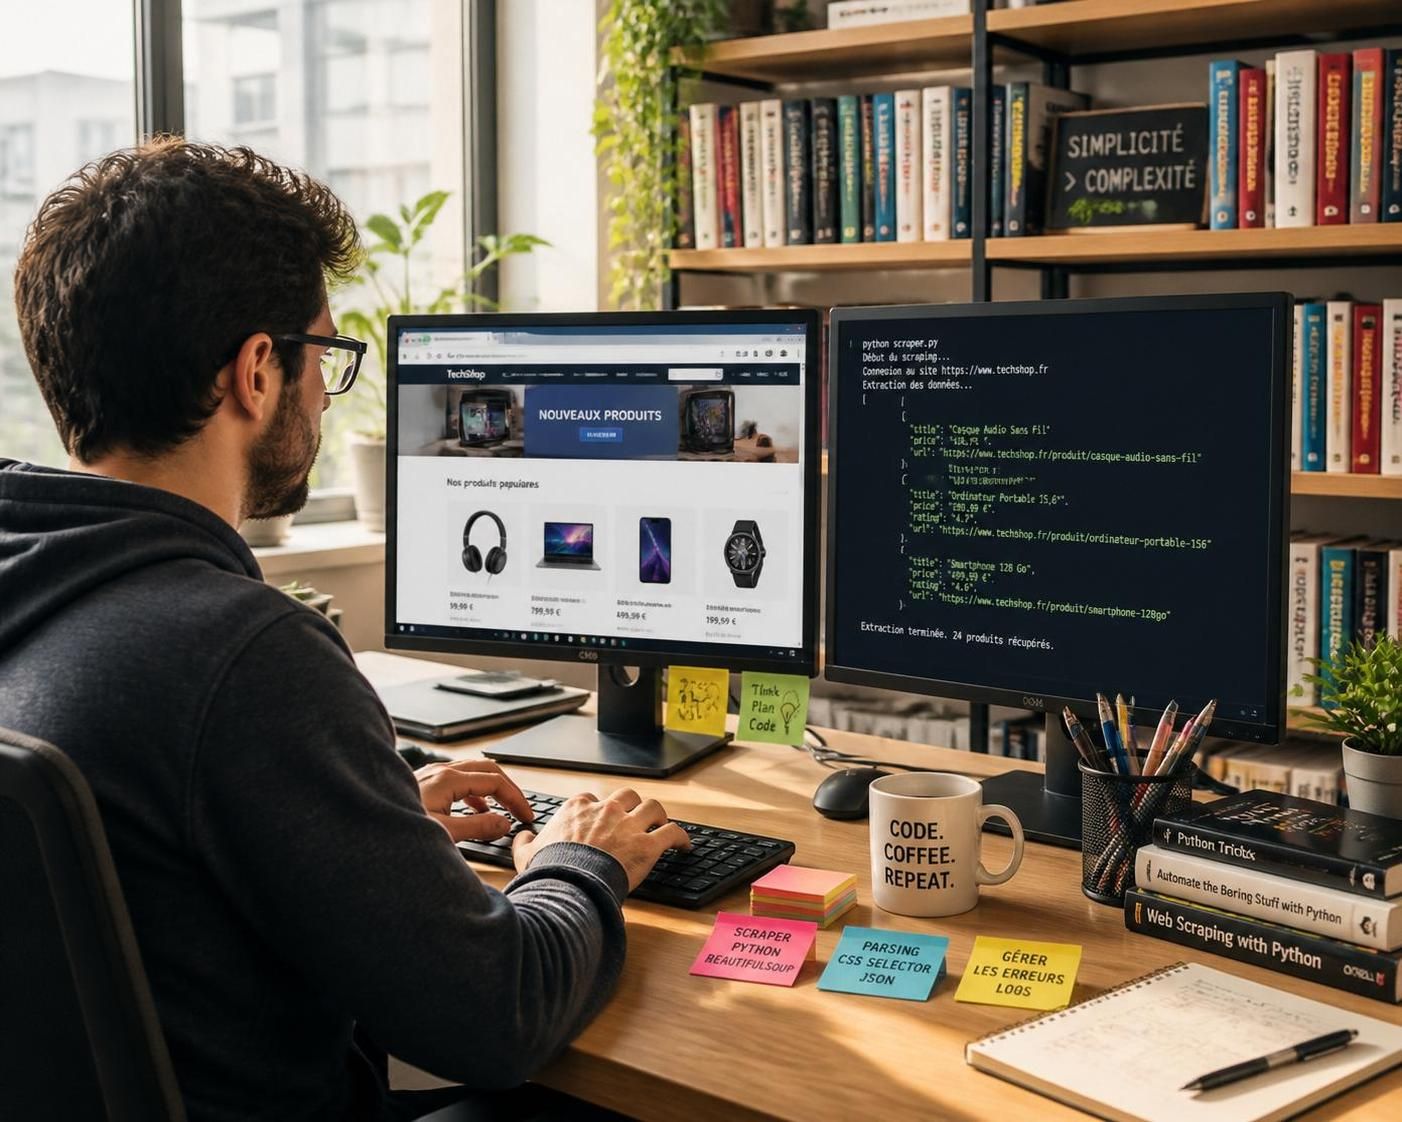
Au cœur du processus, le robot – ou scraper – se charge d’envoyer des requêtes à un site web cible. À chaque réponse du serveur, le contenu reçu (souvent en HTML) est analysé pour extraire les éléments souhaités. Cette méthode permet par exemple de collecter les prix des produits concurrents, de récupérer des notices scientifiques ou de compiler des offres d’emploi issues de plateformes diverses.
Python s’est largement imposé dans ce domaine pour deux raisons : sa simplicité syntaxique et son écosystème mature de bibliothèques spécialisées. Requests est le compagnon idéal pour envoyer des requêtes HTTP, tandis que BeautifulSoup excelle dans l’analyse et la navigation dans le code HTML. Si les pages utilisent beaucoup de JavaScript pour afficher leur contenu, Selenium prend le relais en simulant le comportement d’un véritable utilisateur dans un navigateur. Enfin, Scrapy permet de crawler et de récolter des milliers de pages de façon concurrente, indispensable lorsqu’il s’agit de recueillir de grandes quantités de données.
L’utilisation de ces outils se démarque selon l’objectif fixé. Pour un site statique, quelques lignes de code Requests et BeautifulSoup suffisent pour, par exemple, extraire tous les avis clients d’un site e-commerce. Sur les plateformes dynamiques rendant leur contenu via JavaScript, Selenium devient incontournable pour garantir que le scraper « voie » les mêmes informations qu’un internaute classique.
Le web scraping n’est cependant pas un champ d’expérimentation sans limites. Le respect des règles, qu’elles soient fixées par les sites via leur fichier robots.txt ou dictées par la législation, s’impose comme la première bonne pratique à adopter pour demeurer dans une approche responsable et durable. Avant d’approfondir cet aspect réglementaire, il s’avère utile d’explorer les usages les plus répandus du scraping, des plus classiques aux plus innovants, qui structurent le quotidien des entreprises et des passionnés de data.
Les usages courants et les attentes des professionnels en 2026
En 2026, la diversité des applications du web scraping n’a jamais été aussi large. Dans le secteur du e-commerce, le suivi automatisé des prix rivalise d’ingéniosité pour garantir des comparaisons exactes, cruciales dans une guerre tarifaire devenue mondiale. Les start-up s’appuient sur la collecte de contacts pour déployer des campagnes de prospection ultra-ciblées, mais doivent composer avec des règles RGPD de plus en plus strictes. Les analystes, quant à eux, privilégient le scraping d’articles pour réaliser des veilles automatiques couvrant de multiples sources, tout en restant attentifs à la fiabilité et à la fraîcheur des données.
L’essor des outils de visualisation, comme PyGWalker, permet ensuite d’explorer interactivement les datasets issus du scraping. Cette capacité d’analyse rapide, via Python notamment, révolutionne la prise de décision et l’identification des signaux faibles du marché. Mais chaque automatisation porte en elle une responsabilité : choisir la technique adaptée, s’assurer de l’intégrité des données et ne jamais négliger l’impact d’une extraction trop agressive sur la stabilité ou la sécurité des sites visés.
Légalité du web scraping en France et dans l'Union européenne : panorama 2026 et enjeux d’un site scraper Python
Contrairement à une croyance répandue, le site scraper Python n’est pas en soi illégal en France ni dans la plupart des pays européens. La jurisprudence et les régulateurs, à commencer par la CNIL, ont pourtant balisé un cadre strict, conditionné à la finalité du scraping, à la nature des données collectées et au contexte d’utilisation. Ainsi, extraire des informations librement accessibles demeure possible… sous réserve de respecter les bonnes pratiques légales et les droits intellectuels du propriétaire du site.
Par exemple, le Code de la propriété intellectuelle précise que l’extraction ou la réutilisation d’une partie non substantielle d’une base de données est généralement admise, notamment pour un usage privé ou pédagogique. La bascule dans l’illégalité surgit dès lors qu’est franchi le seuil de la reproduction substantielle, ou que la collecte cible des données à caractère personnel sans consentement clair. En 2026, l’application du RGPD s’est renforcée, imposant notamment aux entreprises une obligation d’information, un droit d’opposition explicite pour les personnes scrappées, et un respect absolu des restrictions en matière de prospection directe.
Prenons l’exemple d’une entreprise fictive, “FreshTrends”, qui surveille les prix d’un leader du marché pour adapter sa propre offre. Si le scraping se limite à des informations publiques telles que les tarifs affichés, l’action est dans la légalité, à condition de respecter le robots.txt du site cible et de n’extraire ni données protégées par le droit d’auteur ni informations à caractère personnel. En revanche, le scraping massif d’une base de données d’utilisateurs relève d’une infraction, passible en France de 5 ans d’emprisonnement et de 300 000 euros d’amende.
| Cas d’usage | Légalité standard | Risques principaux | Sanctions possibles |
|---|---|---|---|
| Extraction de prix publics | Légal (si robots.txt respecté) | Blocage du scraper, violation CGU | Interdiction, contentieux civil |
| Scraping d’e-mails sans consentement | Illégal (violation RGPD) | Sanction CNIL, pénal | Amende 20M€, 5 ans prison |
| Copie de structure BD protégée | Illégal (droit sui generis) | Risques propriété intellectuelle | 300 000€ amende, procédure civile ou pénale |
| Veille pédagogique restreinte | Autorisé (usage privé ou scolaire) | Signalement en cas d’usage commercial | Rappel à loi, contentieux possible |
En résumé, le site scraper Python en 2026 est pleinement accepté sous conditions : respect des limitations techniques, des droits de propriété intellectuelle et des principes RGPD. Rester informé des évolutions réglementaires et consulter régulièrement les CGU des sites reste la meilleure défense contre toute erreur de parcours.
Quelles limites techniques et juridiques ne jamais franchir ?
Il ne suffit pas d’installer une bibliothèque Python pour se prémunir d’un contentieux. Certains sites protègent leur contenu via des mesures anti-scraping (CAPTCHA, restrictions d’IP, obfuscation du code). Outrepasser ces barrières peut être assimilé à un accès frauduleux, même si la donnée initiale était publique. La légalité du scraping dépend alors non seulement du contenu ciblé mais aussi des moyens mis en œuvre pour contourner les restrictions.
Respecter le robots.txt d’un site est une nécessité morale et technique : ce fichier spécifie – pour chaque robot – les zones ouvertes à la collecte et celles formellement interdites. Un manquement répété à ce respect peut entraîner un bannissement automatique ou des poursuites pour extraction déloyale. En France, plusieurs affaires (dont l’arrêt Leboncoin vs Entreparticuliers.com) ont rappelé la portée juridique du droit sui generis, protégeant structure et investissements réalisés sur les bases de données. Il s’agit d’un signal fort, à intégrer systématiquement avant tout scraping à grande échelle.
Robots.txt, RGPD et bonne conduite : trois piliers pour un scraping éthique et responsable
L’un des réflexes essentiels pour tout développeur ou analyste utilisant un site scraper Python est de consulter le fichier robots.txt du site cible. Ce fichier, placé à la racine du serveur (ex : www.monsite.com/robots.txt), définit les autorisations et interdictions destinées aux robots d’indexation et de scraping. Il constitue un signal fort de la volonté de l’éditeur du site : chaque section, chaque répertoire, chaque type de page peut être, selon la configuration, interdit ou ouvert à l’extraction automatisée.
Respecter ce fichier n’est pas seulement une délicatesse technique : c’est la base d’un scraping éthique. En négligeant les restrictions posées (par exemple, collecter des données personnelles ou protégées explicitement interdites par le robots.txt), un scraper bascule dans la déloyauté, risquant des sanctions civiles ou pénales selon la jurisprudence française et européenne.
Le RGPD (Règlement Général sur la Protection des Données) vient renforcer cette exigence de respect. Toute donnée à caractère personnel (identité, adresse électronique, historique d’achat) extraite par scraping entraîne de lourdes obligations, notamment le recueil explicite du consentement, l’information claire des personnes concernées, et le droit d’opposition.
Voici une liste des bonnes pratiques incontournables pour un site scraper Python soucieux de légalité et d’éthique :
- Consulter le robots.txt du site avant chaque opération.
- Limiter la fréquence des requêtes pour ne pas surcharger le serveur cible.
- Respecter les conditions générales d’utilisation (CGU) et mentions légales du site.
- Veiller à ne jamais extraire ni exploiter de données personnelles sans consentement.
- Éviter toute tentative de contournement des systèmes anti-scraping (CAPTCHA, restrictions d’IP…).
- Utiliser des User-Agent explicites (identifiant du robot dans les en-têtes de requête).
- En cas de collecte de données personnelles, réaliser une AIPD (analyse d’impact relative à la protection des données).
- Stocker les données extraites dans des formats structurés et sécurisés (CSV, DataFrame…).
Une démarche responsable repose aussi sur l’information des utilisateurs concernés lorsque leur donnée est collectée et exploitée (ex. prospection commerciale). La CNIL préconise par ailleurs l’évaluation systématique, via l’AIPD, du risque de violation des droits liés aux données obtenues par scraping, notamment dans les secteurs les plus sensibles comme l’assurance, la finance ou la santé.
Éclairages juridiques récents et études de cas de mésusages
En 2020, l’affaire des sociétés scrapant les profils Facebook à des fins de revente ou de constitution de bases de données illégitimes a souligné l’ampleur des dérives potentielles. Facebook a obtenu gain de cause, les entreprises ayant agi sans informer les personnes concernées et sans respecter la finalité annoncée de traitement des données. Plus récemment, la CNIL a aussi sanctionné la récupération de données issues de LinkedIn, lorsque la finalité de prospection commerciale ne présentait pas de lien suffisant avec l’activité professionnelle des personnes démarchées.
À chaque fois, le manquement au RGPD, le non-respect du robots.txt ou des CGU, et une collecte trop massive ou non ciblée, sont pointés du doigt. Ces cas réaffirment la nécessité, pour tout site scraper Python, de s’imposer un audit préalable des règles en vigueur sur la plateforme ciblée et d’agir avec modération technique.
Choisir les bons outils Python et automatiser sans excès : Requests, BeautifulSoup, Selenium et Scrapy à la loupe
Le succès d’une opération de web scraping avec Python dépend autant des outils choisis que de la robustesse du script développé. Plusieurs bibliothèques font référence, avec des usages distincts pour chaque besoin de collecte. Savoir les sélectionner puis les configurer pour garantir rapidité, sobriété et respect du site cible représente un enjeu clé pour préserver l’éthique du scraping.
| Bibliothèque Python | Type de pages cibles | Points forts | Précautions d’usage |
|---|---|---|---|
| Requests + BeautifulSoup | Pages HTML statiques | Installation rapide, très lisible | Ne gère pas le rendu JavaScript |
| Selenium | Pages dynamiques (JavaScript) | Contrôle complet du navigateur, simulation utilisateur | Lent, détectable par les sites, usage modéré conseillé |
| Scrapy | Crawling massif, multi-pages | Gestion de la pagination, pipelines intégrés | Configuration délicate, attention aux limitations robots.txt |
Pour un projet ponctuel, Requests et BeautifulSoup suffisent à extraire en quelques lignes des listes de produits, des prix ou des descriptions directement dans le HTML. En e-commerce, cette combinaison s’avère idéale pour surveiller la fluctuation des tarifs et anticiper la concurrence. Selenium, quant à lui, est à privilégier lorsque le contenu n’apparaît qu’après le chargement du JavaScript – typique sur les sites d’avis clients ou les catalogues dynamiques. Enfin, Scrapy, plus complexe mais très puissant, se prête aux collectes à grande échelle sur des centaines ou milliers de pages, à condition de surveiller assidûment la conformité RGPD et de limiter la cadence des requêtes.
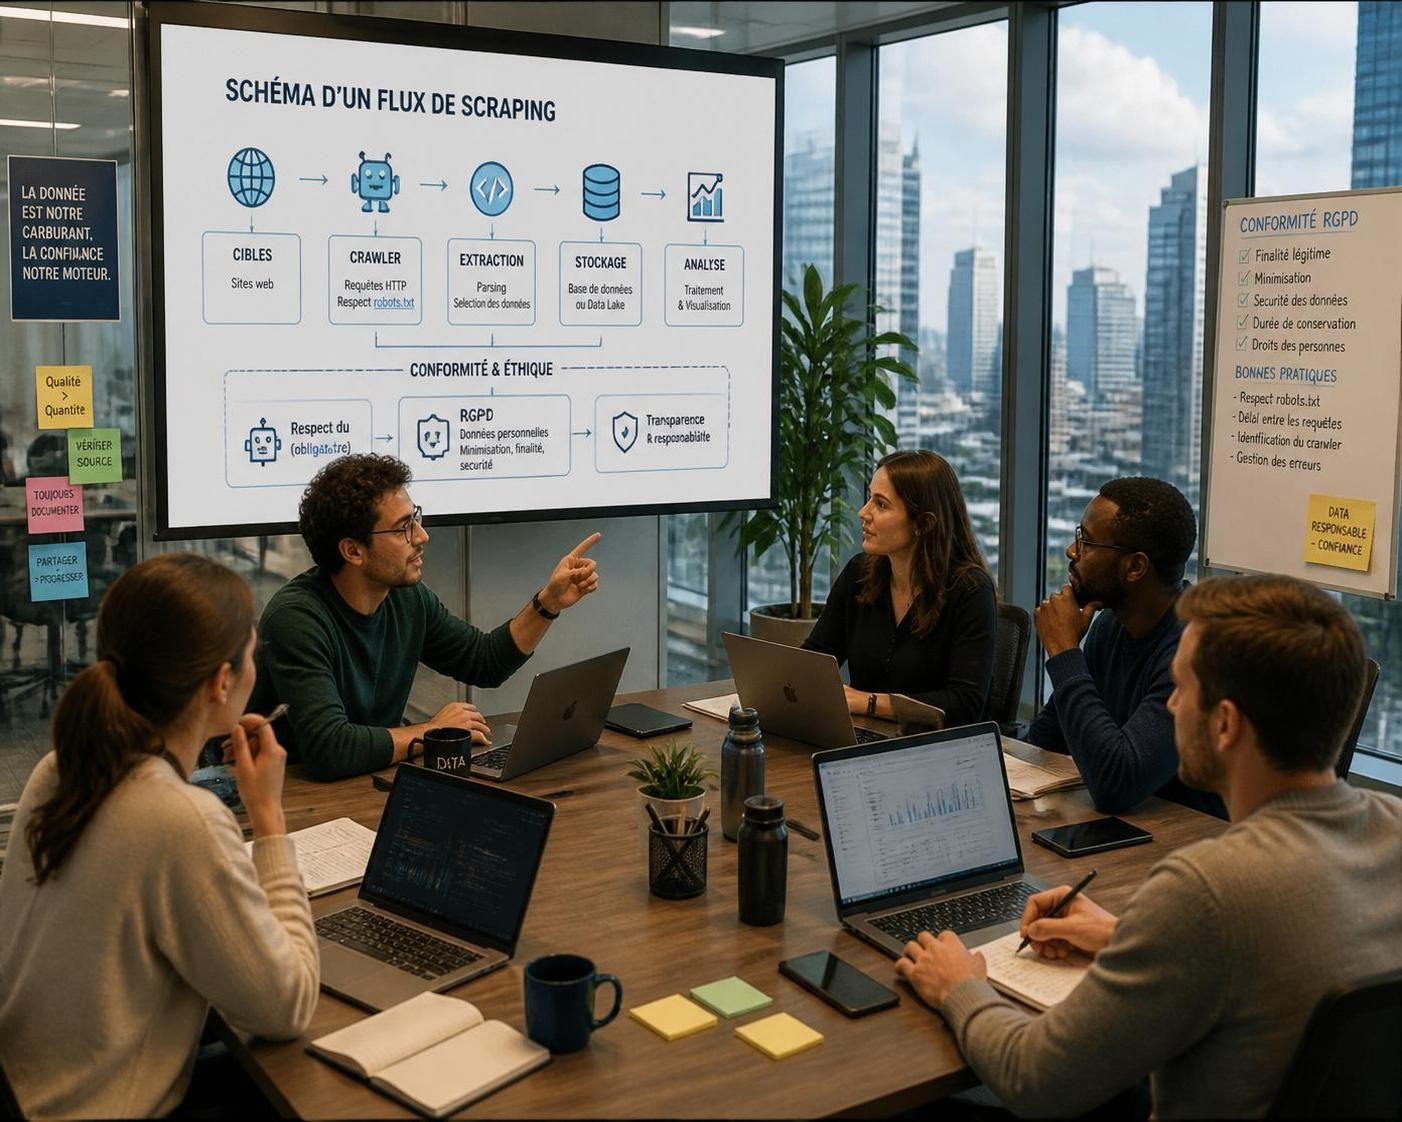
Un autre point déterminant concerne la gestion des sessions et des en-têtes HTTP : pour éviter d’être bloqué, il est recommandé d’espacer les requêtes, d’alterner les identifiants User-Agent et de privilégier les heures de faible affluence pour la collecte de données. Certains outils permettent également de visualiser et de corriger les sélecteurs CSS ou XPath en temps réel, optimisant ainsi la robustesse et la pérennité des scripts automatiques.
Exemples pratiques de clean code pour un site scraper Python éthique
Voici un scénario concret d’application des bonnes pratiques d’automatisation, inspiré d’une entreprise fictive nommée "SmartMonitor" :
- SmartMonitor doit réaliser une veille des prix sur plusieurs sites concurrents, en respectant leur robots.txt pour éviter tout litige.
- Chaque script Python intègre un délai d’au moins 2 secondes entre chaque requête, limitant le risque de surcharge du serveur cible.
- La récupération des données s’effectue uniquement sur les sections autorisées par le robots.txt, excluant toute information à caractère personnel ou protégée.
- Toutes les données sont ensuite stockées dans un format CSV sécurisé, facilitant leur analyse, et aucune tentative de contournement des dispositifs anti-scraping n’est envisagée.
Cette approche exemplaire illustre qu’un site scraper Python bien pensé contribue à renforcer la fiabilité des analyses de marché, sans sacrifier la légitimité ni l’éthique du processus.
Risques, sanctions et responsabilités : pourquoi automatiser exige de la prudence en 2026 ?
Automatiser la collecte d’informations en ligne via un site scraper Python ne va pas sans risques, même avec les meilleures intentions. Les conséquences d’un non-respect des lois ou de l’éthique sont lourdes, tant sur le plan financier que réputationnel. En 2026, les régulateurs disposent d’une palette de sanctions considérable, proportionnelle à la gravité du manquement.
En cas de violation du RGPD – par exemple extraction d’emails ou données sensibles sans consentement –, la CNIL peut infliger jusqu’à 20 millions d’euros d’amende ou 4 % du chiffre d’affaires annuel mondial. Les infractions au droit de propriété intellectuelle ou sui generis sur les bases de données exposent aussi à 5 ans d’emprisonnement et 300 000 € d’amende en droit français. Sans compter les dommages à l’image de l’entreprise et la perte de confiance des partenaires ou clients.
| Infraction | Sanctions potentielles | Mesures correctives recommandées |
|---|---|---|
| Non-respect du RGPD | Jusqu’à 20 M€ d’amende ou 4% CA | Consentement, information, droit d’opposition, AIPD |
| Extraction massive de BD protégée | 300 000€ d’amende, prison jusqu’à 5 ans | Limiter volume, audits juridiques réguliers |
| Passage en force sur robots.txt | Blocage, procédures civiles ou pénales | Consultation en amont, limitation scraping |
Pour alléger ces risques, une check-list rigoureuse est recommandée avant toute automatisation à grande échelle :
- Analyser les CGU, le robots.txt et la structure de propriété des bases de données du site ciblé.
- Ne jamais scraper de données personnelles si le consentement et l’information ne peuvent être garantis.
- Prioriser les accès via des API publiques – souvent plus stables, mieux documentés, et dans le cadre légal explicite.
- En cas de doute, solliciter un avis juridique ou contacter l’éditeur du site pour clarification.
La pratique montre que l’automatisation responsable n’est plus une option : elle s’impose comme unique solution pérenne pour profiter du web scraping, sans courir après les procès ou les mises en demeure. Le respect du robots.txt, la maîtrise des outils Python, et la vigilance face aux dérives, placent enfin le scraping au service de la transparence et de la fluidité des échanges numériques de demain.
Le web scraping avec Python est-il légal en France en 2026 ?
Oui, le scraping de données accessibles publiquement reste légal sous conditions : il faut impérativement respecter le fichier robots.txt, les conditions générales d’utilisation des sites et le RGPD pour la collecte de données personnelles. Toute extraction malveillante ou massive peut cependant entraîner des poursuites.
Quelles différences entre Requests, BeautifulSoup, Selenium et Scrapy dans le scraping Python ?
Requests et BeautifulSoup conviennent pour le scraping ponctuel de pages HTML statiques. Selenium s’utilise pour extraire des données affichées par JavaScript, en simulant un navigateur. Scrapy vise le crawling à grande échelle et la gestion de pipelines de données, mais doit respecter plus scrupuleusement robots.txt, sous peine de blocage ou de sanctions.
Que risque-t-on en cas de non-respect des règles lors d’un site scraper Python ?
Les risques incluent des sanctions pécuniaires (jusqu’à 20 M€ d’amende pour le RGPD, jusqu’à 300 000 € pour la violation du droit des bases de données), des blocages techniques par le site visé, voire des peines de prison selon la gravité des infractions (caractère personnel ou protégé des données, extraction frauduleuse…).
Comment s’assurer que le site scraper Python respecte les principes éthiques et légaux ?
Toujours consulter le robots.txt, espacer les requêtes, éviter la collecte de données sensibles, demander le consentement clairement quand cela est requis, stocker les données en toute sécurité et privilégier l’utilisation d’API lorsque possible. Réaliser une analyse d’impact RGPD (AIPD) est également recommandé en cas de doute.
Existe-t-il des outils pour visualiser et analyser les données scrapées légalement ?
Oui, des outils libres comme PyGWalker et pandas, intégrés à l’écosystème Python, permettent de visualiser, d’explorer et d’analyser rapidement des datasets issus du web scraping, dès lors que les pratiques de collecte ont été respectueuses du cadre légal.