L’extraction du contenu d’une page HTML s’impose aujourd’hui comme une compétence recherchée, aussi bien chez les passionnés du web que chez les professionnels à la recherche d’informations fiables ou d’outils automatisés. Des solutions rapides grâce à des extensions pour navigateur, à des techniques avancées de web scraping, chacun peut désormais récupérer le contenu HTML d’un site pour ses propres besoins, tout en restant attentif aux nouvelles pratiques technologiques et aux règles d’éthique numérique qui évoluent en 2026.
- Récupérer contenu HTML : enjeux croissants pour documentation, veille ou automatisation
- De nombreuses méthodes, allant des extensions à l'automatisation IA et au parser HTML
- Utilité pour la surveillance d’informations, l’analyse des données ou la sécurisation des ressources
- Astuces pratiques pour optimiser l’extraction données page web sans perdre de temps
- Mises en garde sur l’éthique, la sécurité et le respect des droits numériques
Méthodes accessibles pour récupérer le contenu HTML d’une page web
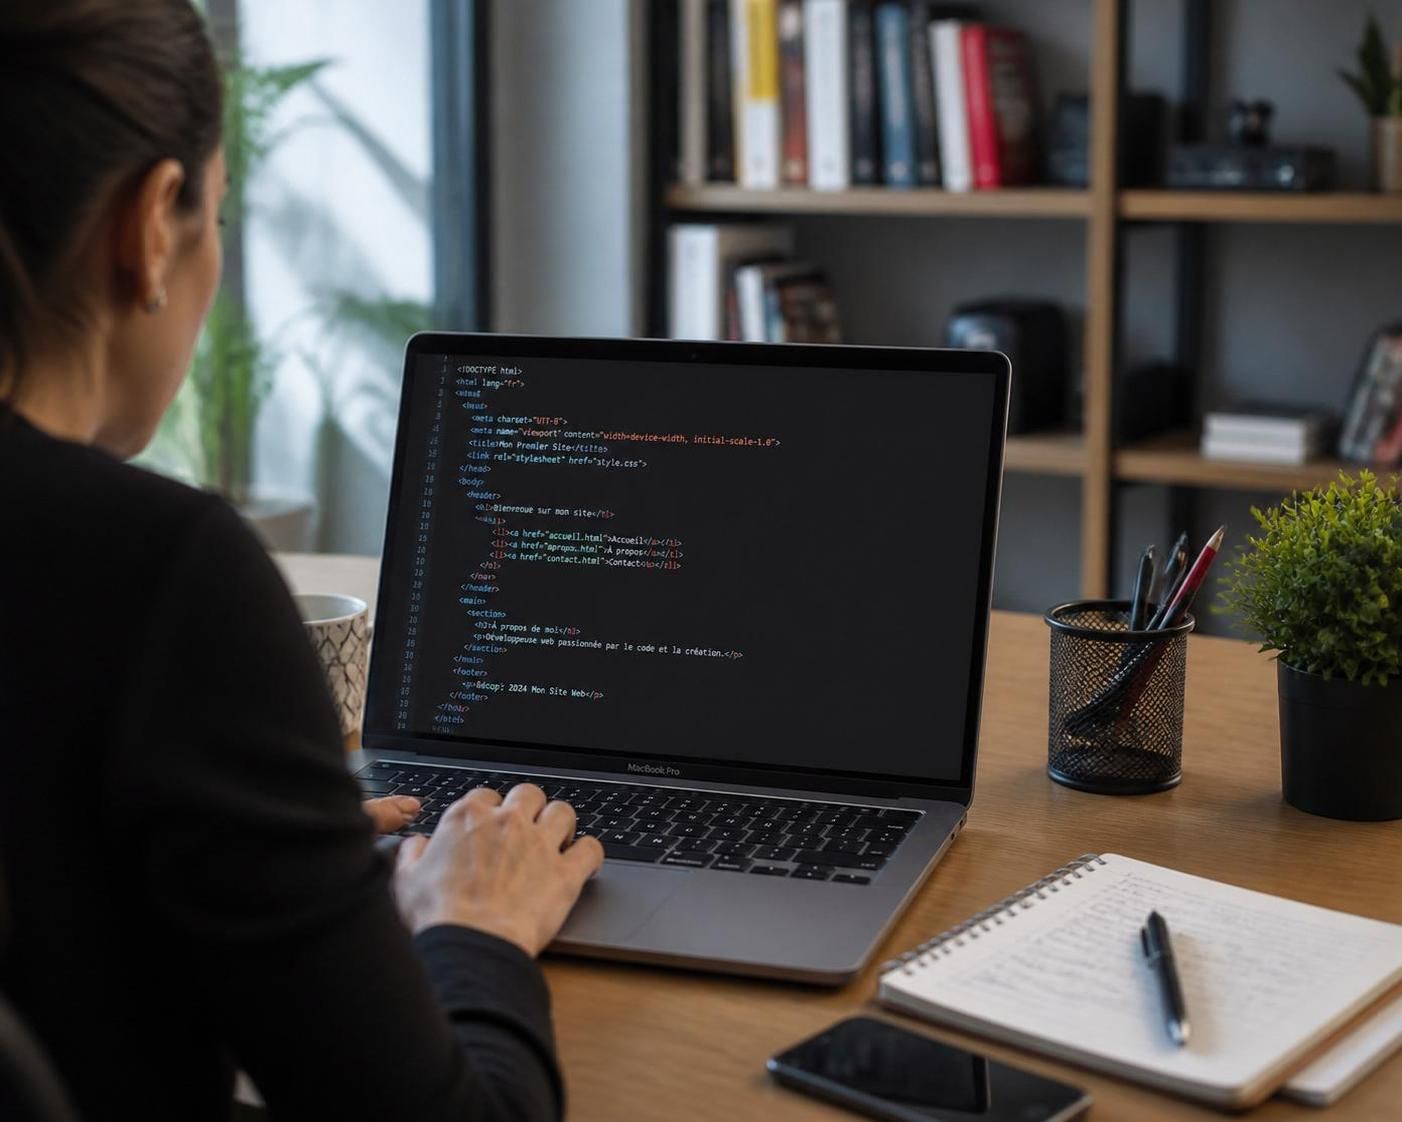
La récupération de contenu HTML ne se limite plus aux technophiles aguerris. Avec la montée en puissance d’outils conviviaux et de techniques claires, chacun peut désormais se lancer dans l’extraction données page web, que ce soit pour l’archivage de documents, la réalisation d’analyses ou le suivi d’actualités. L’une des approches les plus simples consiste à utiliser les fonctions natives des navigateurs : un clic droit, suivi de « Afficher le code source », permet de visualiser et copier l’intégralité du code HTML d’une page.
Au-delà de cette méthode manuelle, des extensions dédiées simplifient la tâche. Des modules comme Web Scraper ou Instant Data Scraper proposés pour Chrome et Firefox offrent des interfaces visuelles pour sélectionner des éléments, extraire du texte ou des images, et même exporter les données vers des tableurs. Ce type d’outil récupération page web s’avère idéal pour un besoin ponctuel ou pour ceux qui ne maîtrisent pas de langage de programmation.
Face à la diversité des cas d’usage, les plateformes no code représentent une alternative remarquable. Elles proposent des scénarios prêts à l’emploi pour collecter, organiser et filtrer les contenus d’une page sans écrire une seule ligne de code. Certaines solutions permettent par exemple de centraliser automatiquement des catalogues produits ou des informations de presse sur Google Sheets ou Airtable, comblant le fossé entre accessibilité et performance.
Enfin, pour les utilisateurs soucieux d’archiver du contenu lisible hors connexion, la fonctionnalité « Enregistrer sous » du navigateur reste un incontournable. Elle conserve l’arborescence et la structure originale, même si certaines limitations persistent, notamment concernant les scripts dynamiques ou les contenus interactifs générés à la volée.
L’essentiel réside dans le choix de la méthode la plus adaptée à ses besoins, selon le volume de pages à traiter, la fréquence de mise à jour souhaitée et les contraintes techniques de chaque site cible. Cette pluralité d’approches marie alors simplicité, efficacité et adaptabilité, ouvrant l’extraction HTML à un large public en quête d’autonomie numérique.
Enjeux d’accessibilité et cas d’usage quotidiens
Au quotidien, la récupération du contenu HTML permet, par exemple, d’extraire rapidement la liste des événements d’un site culturel pour créer un agenda personnel ou d’archiver des modes d’emploi essentiels pour les relire hors ligne. Ce besoin se retrouve aussi lors de migrations de sites web ou d’études comparatives à grande échelle.
Lutter contre la volatilité de l’information et garantir un accès permanent aux ressources reste un défi pour de nombreux internautes et professionnels en 2026.
Web scraping avancé : automatiser l’extraction avec des outils de nouvelle génération
L’automatisation extraction de contenus via le web scraping permet aujourd’hui d’aller largement au-delà de la simple sauvegarde d’une page. Grâce à l’essor des solutions spécialisées, il devient possible d’automatiser la collecte de données structurées, d’images ou de tableaux provenant de plusieurs sites, sans intervention humaine à chaque étape.
Des systèmes no code tels qu’Octoparse et des plateformes cloud proposent des scénarios préconçus pour le scraping intensif. Ils dessinent des parcours à travers le site cible, identifient automatiquement les boutons de pagination ou les sélecteurs CSS, et programmateurs des analyses DOM sans configuration complexe. Pour les professionnels, la possibilité de transférer directement ces données vers des solutions comme Notion ou Airtable favorise l’intégration immédiate à des workflows numériques.
Certaines extensions de navigateur misent sur la facilité d’utilisation : il suffit de cliquer sur un élément, d’ajouter une règle, et l’extension lance l’extraction pour extraire du texte, des URL ou le code HTML complet d’un bloc précis. Cela s’avère particulièrement utile pour la réalisation de veilles concurrentielles ou des campagnes de surveillance SEO, où la rapidité prime sur la personnalisation extrême.
Lorsque les besoins s’orientent vers le traitement de très grands volumes de pages, l’automatisation par scripts Python ou R, souvent accompagnés de librairies comme Beautiful Soup, Selenium ou Puppeteer, prend toute sa dimension. Ces outils, tout en exigeant quelques compétences en développement, assurent une robustesse et une répétitivité à grande échelle.
S’appuyer sur un parser HTML professionnel devient alors nécessaire pour extraire avec précision les données nichées au sein d’une arborescence complexe. Cela garantit la récupération d’éléments spécifiques, même au sein de structures dynamiques alimentées en JavaScript, où le simple copier-coller n’aurait aucun effet.
Pour ceux qui cherchent à comprendre ou approfondir le potentiel de cette discipline, il peut être utile de consulter des ressources spécialisées telles que ce guide sur le scraping en Python avec gestion des robots, ou encore des articles généralistes sur l’utilisation de l’IA et des scripts pour l’extraction rapide, voire sur l’évolution des techniques no code apparues depuis 2025.
Automatisation, contraintes éthiques et gestion des limites techniques
La recherche d’efficacité via l’automatisation ne doit toutefois pas occulter les contraintes posées par certains sites. La présence de CAPTCHAs, la protection par authentification ou des restrictions liées au fichier robots.txt sont autant de barrières qui imposent des stratégies adaptées. Les professionnels du scraping soucieux du respect de la loi veillent aussi à s’informer sur les limites juridiques, évitant ainsi la collecte abusive ou le partage non autorisé de contenus protégés.
L’optimisation passe également par des astuces scraping éprouvées, telles que le « random delay » entre les requêtes ou la sélection dynamique de proxies pour éviter les blocages liés à l’adresse IP. Ce sont là des aspects incontournables pour garantir une automatisation durable et respectueuse de l’écosystème web.
Parser HTML et analyse DOM : approcher l’extraction comme un expert
Le parsing HTML s’impose comme l’étape décisive pour manipuler et extraire précisément le contenu voulu, surtout lorsque la structure de la page est complexe ou régulièrement modifiée. À la différence des méthodes visuelles ou « point and click », l’analyse DOM (Document Object Model) permet de cibler spécifiquement les balises, attributs et classes CSS pertinents pour la récupération du texte, des liens ou d’autres éléments structurés.
Les solutions modernes de parsing proposent des interfaces graphiques où l’on navigue dans l’arbre DOM, sélectionnant d’un simple clic la zone souhaitée (titre d’article, image principale, lien vers une ressource externe, etc.). Pour les profils techniques, l’écriture de sélecteurs CSS ou XPath sur mesure autorise une extraction fine, particulièrement utile dans la recherche scientifique ou le journalisme de données.
Dans le domaine de la récupération HTML, l’analyse DOM joue un rôle clé pour anticiper d’éventuels changements de structure. Ainsi, un script bien conçu s’ajustera automatiquement lors d’une mise à jour esthétique sur le site ciblé, tandis que les outils automatisés apporteront une plus grande robustesse face aux évolutions fréquentes du web.
Pour illustrer cette puissance, prenons le cas d’un éditeur de presse locale souhaitant recueillir tous les titres des dernières publications pour alimenter un fil d’actualités. Grâce à un parser HTML avancé, l’extraction peut se faire à partir d’une liste d’URL obtenue en amont, en assurant la cohérence de la récupération malgré les variations stylistiques ou l’ajout de nouvelles rubriques.
La flexibilité du parsing HTML ne cesse de croître avec l’arrivée de solutions hybrides, combinant IA et analyse structurelle. En 2026, de plus en plus de plateformes cloud sont capables de reconnaître automatiquement les patterns récurrents et d’alerter l’utilisateur lors de modifications significatives, assurant ainsi une surveillance continue sans intervention humaine immédiate.
Voici un exemple de tableau synthétisant les différences principales entre parsing visuel et analyse DOM avancée :
| Méthode | Avantage principal | Limite technique | Cas d’usage recommandé |
|---|---|---|---|
| Parsing visuel (point and click) | Accessible et rapide à prendre en main | Fragile lors de mise à jour de la page | Extraction ponctuelle, projets simples |
| Analyse DOM avancée | Adaptabilité et précision | Demande des notions de structure HTML/CSS | Veille automatisée, projets complexes |
Cas d’usage et bénéfices pour la veille et l’analyse professionnelle
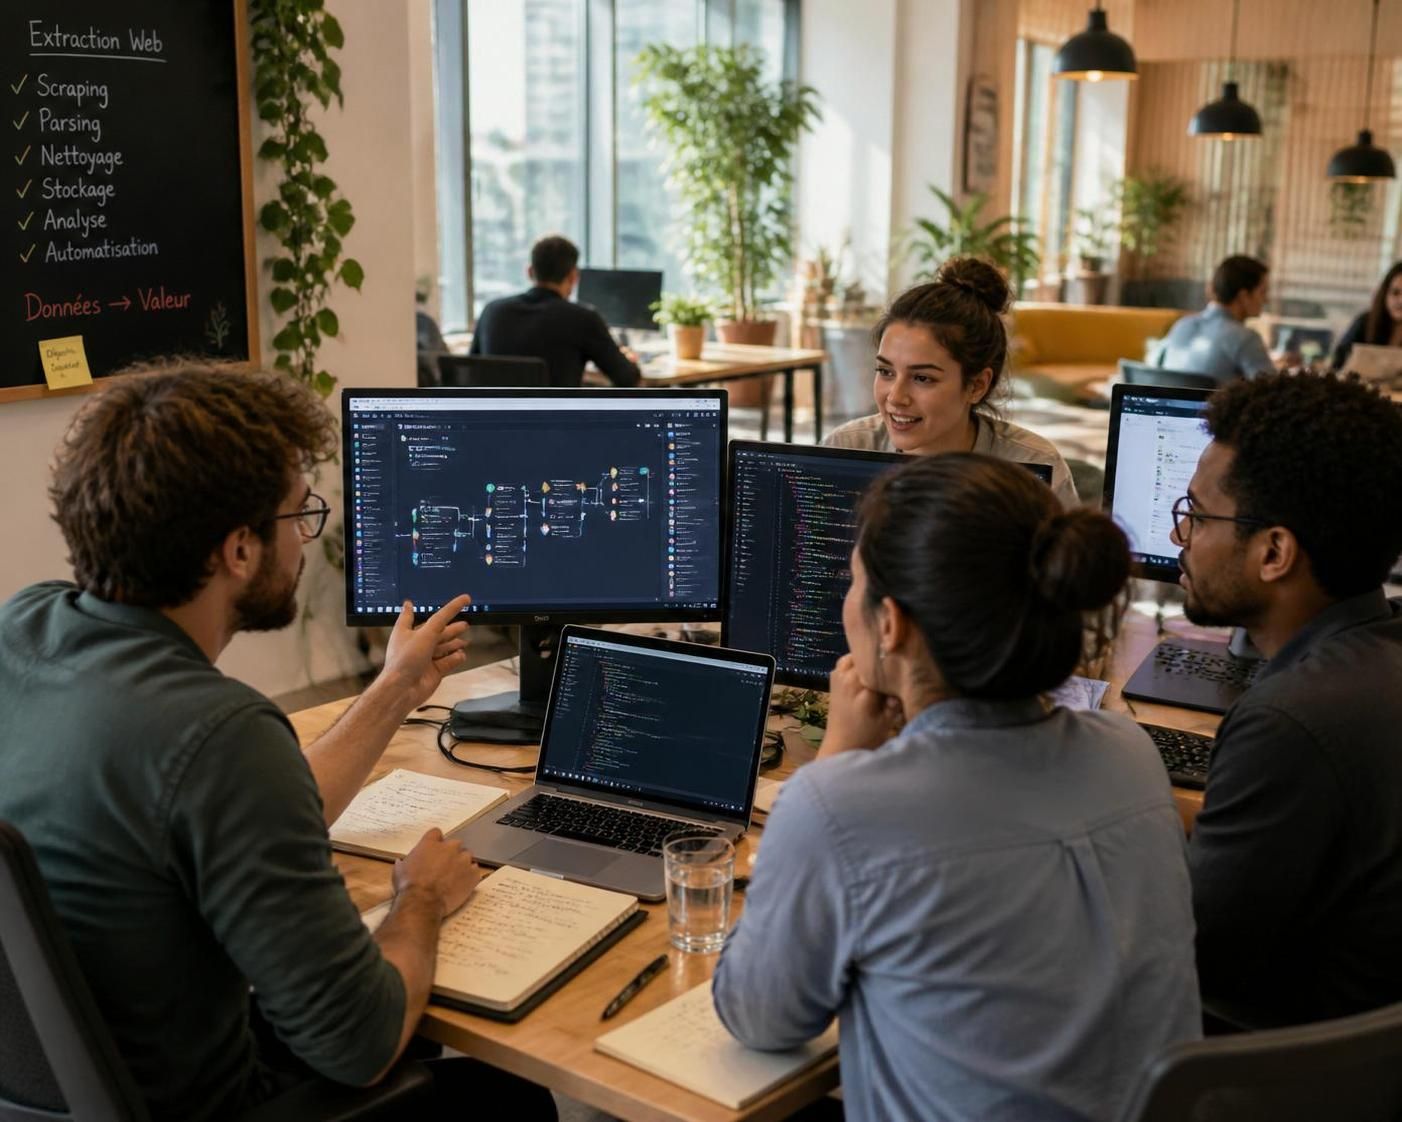
Cette distinction s’avère précieuse pour les professionnels du web scraping qui doivent extraire en continu des données sur plusieurs sites dans les secteurs de l’e-commerce, de la surveillance SEO ou de la presse. Une analyse DOM robuste permet de gagner un temps considérable lors de mises à jour techniques des pages sources.
Éthique, sécurité des données et bonnes pratiques dans l’extraction HTML
Extraire et récupérer le contenu HTML d’une page suppose de se poser des questions fondamentales en matière d’éthique et de respect de la vie privée. En 2026, les réglementations sur la protection de la donnée, largement renforcées à l’échelle européenne, imposent une vigilance accrue à toute personne ou entreprise recourant à des techniques d’extraction de données page web, qu’il s’agisse d’usage personnel ou professionnel.
Parmi les bonnes pratiques à respecter : toujours vérifier les conditions d’utilisation du site ciblé et éviter l’exploitation de contenus protégés ou soumis à des restrictions spécifiques. L’usage d’un outil récupération page web ne dispense jamais de l’obligation morale et légale de respecter la propriété intellectuelle et de demander, le cas échéant, une autorisation explicite.
Les questions de sécurité ne sont pas en reste. L’extraction de contenu, réalisée via des outils tiers ou des scripts personnalisés, expose potentiellement à des risques d’intrusion ou de corruption des données. Il convient donc de privilégier les logiciels reconnus, de mettre à jour ses outils et d’utiliser des méthodes de stockage sécurisées. Pour approfondir cette dimension, des ressources détaillées telles que ce guide sur la protection et la sauvegarde des données peuvent s’avérer précieuses.
Par ailleurs, l’usage de plateformes cloud pour automatiser l’extraction nécessite d’accorder une attention particulière à la confidentialité des informations transférées. Le recours à des solutions compatibles RGPD et l’identification de leur politique de stockage restent essentiels pour éviter tout usage détourné de données sensibles.
En matière d’éthique, la transparence dans l’utilisation des données extraites, l’indication claire de la source et l’absence de manipulation ou de diffusion abusive des résultats assurent le maintien d’un environnement numérique respectueux et sain. Les acteurs de la filière sont ainsi régulièrement invités à mettre à jour leurs pratiques, à sensibiliser leurs équipes et à renforcer la confiance dans les processus d’extraction HTML.
Liste des principaux risques à surveiller lors de l’extraction
- Violation des droits d’auteur sur contenu protégé
- Extraction de données personnelles sans consentement
- Risque d’infection par logiciels malveillants via scripts non sécurisés
- Dépendance à des outils cloud dont la politique de confidentialité est opaque
- Exposition à des sanctions juridiques en cas de non-respect des CGU
Astuces pratiques et outils à connaître pour optimiser la récupération de pages HTML
À l’ère de la digitalisation massive, le besoin d’optimiser la méthodes récupération HTML se traduit par le recours à des astuces scraping éprouvées et des outils performants. Commencer par bien cartographier la page à extraire reste une étape clé : une navigation attentive dans l’arborescence HTML permet d’éviter la récupération de contenus superflus ou de tomber dans le piège des contenus cachés par du JavaScript.
Des astuces simples s’avèrent souvent déterminantes : repérer les gabarits récurrents dans l’URL, exploiter les paramètres de requête GET pour paginer intelligemment ou définir des filtres précis selon les besoins d’extraction. Les utilisateurs avertis mettent en place des scripts d’analyse DOM permettant de détecter automatiquement la présence de nouveaux blocs ou d’images, facilitant l’adaptation lors de mises à jour du site cible.
L’intégration d’outils complémentaires tels que la récupération automatique des exports CSV, l’envoi automatisé de notifications ou la connexion directe avec des plates-formes cloud gratuites (présentées par exemple dans cette sélection d’outils cloud recommandés en 2026) accroît considérablement la productivité, sans sacrifier la sécurité des traitements.
Pour les professionnels, l’implémentation de logs d’extraction, d’alertes en cas d’erreur et de contrôles qualité en continu s’avère essentielle pour garantir la fiabilité des données récupérées. C’est un savoir-faire qui se construit avec l’expérience et l’échange régulier avec la communauté technique — forums, newsletters spécialisées et ressources en ligne apparaissent ici comme des alliés incontournables.
L’optimisation passe aussi par la maîtrise des outils les plus adaptés à chaque besoin. Voici un exemple de liste d’outils déjà éprouvés sur le marché :
- Extensions Chrome/Firefox dédiées à l’extraction rapide
- Plateformes no code proposant des parcours d’extraction prêts à l’emploi
- Librairies Python/R pour les utilisateurs avertis
- Solutions cloud pour l’automatisation et la centralisation des données extraites
- Systèmes de notification et d’alertes pour la surveillance en temps réel
Chacune de ces catégories d’outils répond à des profils et des projets distincts, permettant à tout utilisateur — du simple curieux au data analyst accompli — d’intégrer l’extraction de contenus HTML à ses routines numériques avec précision et confiance.
Quels outils choisir pour démarrer la récupération de contenu HTML ?
Les débutants peuvent utiliser des extensions de navigateur comme Web Scraper ou Instant Data Scraper. Pour des projets plus avancés, les plateformes no code ou les librairies Python telles que Beautiful Soup sont recommandées, selon le volume de données et la fréquence d’automatisation recherchée.
Quels sont les risques éthiques ou légaux du scraping de page web ?
L’extraction de contenu doit se faire dans le respect du droit d’auteur, des conditions d’utilisation du site et des réglementations sur la protection des données (notamment RGPD en Europe). Évitez de collecter des données personnelles ou protégées sans consentement explicite.
Comment s’assurer de la qualité des données extraites ?
La fiabilité dépend d’une bonne cartographie préalable du site, de tests réguliers des scripts ou outils utilisés, et d’une veille active sur les changements de structure des pages. L’intégration de contrôles qualité et de logs d’erreur améliore la robustesse du processus.
Est-il possible d’automatiser complètement la récupération HTML ?
Oui, grâce aux solutions cloud et aux scripts personnalisés, il est possible d’automatiser l’extraction, la transformation et l’export des données, tout en paramétrant des notifications en cas d’échec ou d’évolution du site cible.
Comment protéger les données extraites lors de leur stockage ?
Utilisez des services cloud reconnus et conformes au RGPD, limitez les accès aux personnes habilitées, chiffrez les fichiers sensibles et privilégiez des solutions disposant d’audit de sécurité régulier pour prévenir toute fuite de données.